10月19日,存算协同芯片公司铭芯启睿(MemSilicon)宣布完成超4亿元A轮融资。
博原资本领投,博世创投、创领资本、米哈游、中关村科学城公司、兆易创新等跟投,老股东复容投资、国开科创、恒裕资本、锦秋基金、顺禧基金、小米战投、中科创星持续加注。
比融资数字更引人注目的,是铭芯启睿于同日披露的一项人事变动:前Graphcore总裁兼大中华区总经理卢涛加入铭芯启睿,出任CEO兼联合创始人。
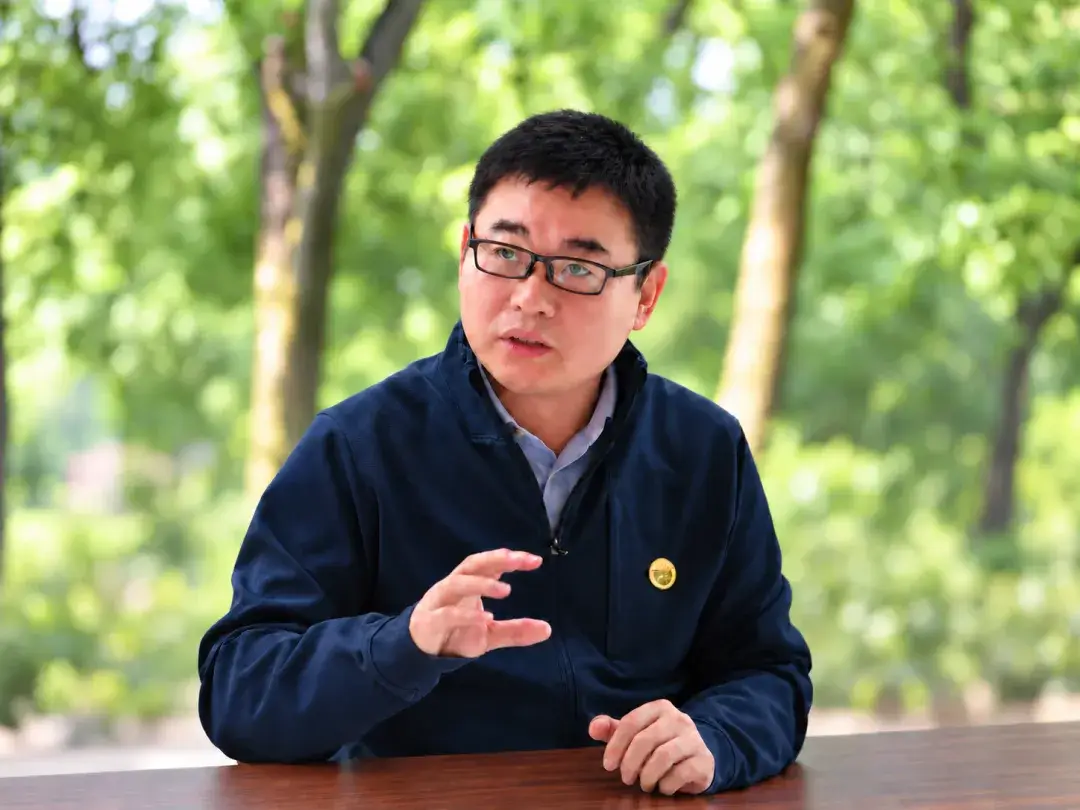
△卢涛
卢涛在芯片行业深耕二十余年,履历覆盖Cavium中国区总经理、曦智科技副总裁、Graphcore总裁兼大中华区总经理,横跨Arm服务器CPU、DPU、硅光芯片以及大SRAM架构的AI处理器IPU等多个领域。
博原资本管理合伙人蒋红权直言,对铭芯的信任“始自十年前的Graphcore渊源”。卢涛这样一位既经历过Graphcore挑战英伟达的完整周期、又深谙中国市场落地逻辑的操盘手,对于铭芯启睿这样一家技术底色浓厚但商业化经验尚浅的初创公司而言,价值不言而喻。
同时,铭芯启睿宣布公司战略全面升级:在继续推进阻变存储器(RRAM)产品化的基础上,启动面向大模型推理的第一代LPU研发,打造“满血模型、高速Token、越级性价比”的新一代推理引擎。
这距离铭芯启睿首款RRAM芯片“泰山一号”流片消息传出,仅过去一周。一家成立仅两年多的存储芯片公司,在完成从实验室到流片的跨越后,迅速将触角伸向了计算——而且是当下最拥挤也最诱人的大模型推理赛道。
Agentic AI改写推理需求,存算协同成为破局点
如果说过往的AI对话是“一问一答”,那么Agentic AI时代的多轮推理、工具调用、上下文复用乃至多Agent并行,正在把推理任务从短跑变成接力赛。相关研究数据显示,在缓存有效命中的条件下,解码环节占据LLM执行时间的91%到98.6%。这意味着,用户等待Agent完成任务的绝大部分时间,花在了“逐Token搬运数据”上。
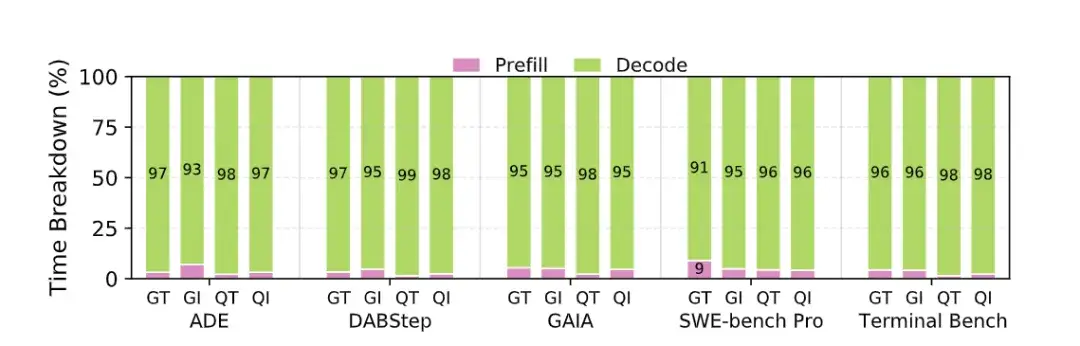 △数据来源:arxiv2605.26297v2, Agentic AI Workload Characterization
这恰恰是传统GPU架构的软肋。解码本质上是内存搬运密集型任务,每生成一个Token,都要反复搬运模型权重与KV缓存。堆叠GPU数量可以压低延迟,代价是功耗、网络复杂度和单位成本同步攀升。显然,单纯依赖单一维度的算力提升,已经走不通了,所以必须从系统层面重新回答“算什么、在哪里算、权重怎么存、数据怎么传”。
对此,铭芯启睿的定位很明确,不与GPU内卷,聚焦满血模型的高速Token体验,用越级性价比,服务高端推理市场。这当中的关键着力点在于“突破存储与数据搬运瓶颈”,铭芯启睿的选择是,把RRAM(阻变存储器)的存储密度优势,与系统级的计算、互联协同设计结合起来。PRAM是一种通过施加电压改变介质材料电阻状态来存储数据的非易失性存储器,具有结构简单、读写速度快、可微缩性强且与标准CMOS工艺兼容的特点。
而铭芯启睿的核心团队源自中国科学院刘明院士团队,在RRAM相关材料、器件、工艺、芯片设计等底层技术上,拥有二十多年的深耕积累。从材料与器件物理出发,团队的工作延伸至可靠性、工艺集成、IP和芯片设计,再推进到流片验证与应用;除RRAM外,团队在三维集成、近存计算及混合存算一体架构方面也具备深厚科研积累。
卢涛指出,“依托中国领先的存储战略纵深,结合我们在AI芯片产品定义与产业落地上的积累,铭芯启睿正同步推进RRAM产品化和下一代LPU研发,加速存算协同落地。”
PRAM芯片“泰山一号”完成流片
值得注意的是,就在A轮融资公布前一周,10月14日,铭芯启睿宣布其基于1TnR技术路线的首款高密度、大容量PRAM芯片“泰山一号”完成了流片。
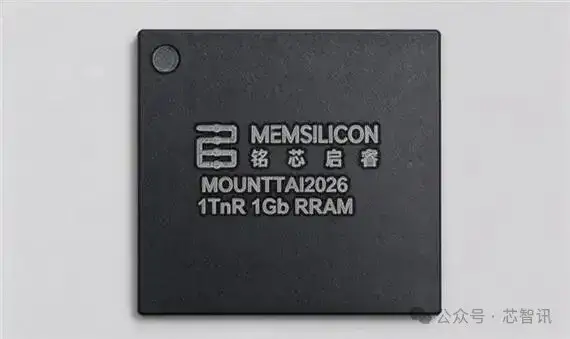
据介绍,“泰山一号”是铭芯启睿将1TnR高密度、大容量新型存储芯片技术从早期研究推向Gb级芯片产品化的里程碑。这一技术路线通过多个阻变存储单元共享选择晶体管,提高单位面积内的存储容量,并利用与CMOS平台完全兼容的后道集成方式,实现了密度、容量和成本兼得。
该芯片采用28nm CMOS工艺平台和1T4R单元结构,单芯片容量1Gb,存储密度30Mb/mm²,访问延时小于20ns,并集成片上硬件纠错电路,在大容量、高密度与高速读取之间实现了协同突破,为片上高密度大容量新型非易失存储应用提供了具有国际竞争力的解决方案。
需要指出的是,1TnR路线的核心逻辑,是通过多个存储单元共享选择晶体管,在有限面积内塞进更多容量,同时保持与标准CMOS工艺的兼容性。这对于需要承载更大模型参数和KV缓存的推理场景而言,是一条从存储侧逼近瓶颈的路径。
从RRAM到LPU:双线并进,协同创新
铭芯启睿目前的产品矩阵的最底层是嵌入式RRAM IP,面向显示驱动、MCU、SSD控制器等场景,公司称已进入客户场景,但未披露具体客户与订单规模;中间层是以“泰山一号”代表的大容量独立式RRAM,目前仍在推进验证,量产时间表尚未公布;最上层,则是刚刚启动的第一代LPU。
铭芯启睿的LPU研发目标颇为激进:支持数万亿参数的完整模型,不依赖量化或投机解码,实现每用户每秒1000个Token的生成速度。作为参照,当前主流云端推理服务在长上下文场景下的输出速度往往在几十到百余Token每秒量级。如果这一目标能够兑现,意味着Agent完成任务的时间可以从分钟级压缩到秒级。
值得一提的是,铭芯启睿的这种“存储+计算”双线自研并进的模式,在初创芯片公司中并不常见。通常的逻辑是,在单一赛道做到足够深再考虑延伸。
但卢涛的加入改变了公司的节奏。董事长刘琦的表述很坦诚:“过去我们是领先的RRAM技术团队;随着卢涛先生的加入,我们得以从产品定义之初,就把RRAM与LPU的架构创新、工程实现、客户需求和商业交付放在一起考虑。”换句话说,LPU不是一次心血来潮的跨界,而是被设计为RRAM技术价值的放大器——存储器的密度和能效优势,最终需要在推理系统的整体表现中被客户感知和付费。
投资人显然认可这一叙事。小米战投在持续加注时提到,看重“存储与计算协同创新的产业价值”,并称见证公司“从新存储向新计算的升级”。锦秋基金合伙人郑晓超则直接点出了对卢涛个人的判断:“具备国际化视野、浪漫又务实的创业者”。
野心与现实之间的距离
虽然铭芯启睿RRAM的进展顺利,但是LPU仍处于极早期阶段,后续的协同整合则可能更为遥远。
卢涛在采访中确认,LPU目前处于研发阶段,首代产品尚未流片,没有实测性能数据支撑。他组建的LPU核心团队目前规模在十几人量级,覆盖硬件、编译器和系统软件。对于一个要对标高端推理体验的芯片项目而言,这个体量只能算起步。并且,铭芯启睿第一代LPU并不直接采用RRAM,而是使用更成熟的存储介质先跑通产品,RRAM的积累会在后续迭代中逐步注入。
相比之下,Groq的LPU已经在特定推理场景中证明了低延迟的可行性,而英伟达的迭代节奏从未放缓。国内亦有初创公司在LPU推理芯片方向布局。
铭芯启睿的差异化在于,它试图把存储器件层面的创新纳入推理架构的定义之中,而不是在现有的存储层级(HBM、SRAM)框架内做优化。这条路如果走通,壁垒会更高;但如果RRAM的可靠性或工艺成熟度在系统级验证中暴露短板,产品化的节奏就可能被拖慢。“泰山一号”目前仍处于验证阶段,尚未披露量产客户,这本身就是一个需要时间消化的变量。
卢涛对此似乎有清醒的预期。他用高铁打比方:用户愿意为更快的速度和更好的体验支付溢价,但如果普通票200元、高铁票2000元,就很难普及。LPU的定价逻辑必须是“比普通服务贵,但溢价有限”。在关键场景里,超时就是失败,Token的时效/成本比会越来越成为客户买单的理由。
此次超4亿元A轮融资到账,给了铭芯启睿至少两到三年的试错窗口。卢涛需要在这段时间里证明两件事:第一,一支以存储器件起家的团队,有能力做出系统级的推理芯片;第二,RRAM积累下来的存算协同能力,在真实的Agentic AI负载中,能转化为客户可感知的速度与成本优势。
刘明院士在融资公告中的寄语,或许是对这件事最准确的注脚:“只有把科研积淀转化为系统能力,才能真正探索从基础科研走向系统创新的路径。”从实验室到流片,铭芯启睿已经走完了第一步。从流片到量产交付,才是真正检验“路在脚下”的时刻。
编辑:芯智讯-浪客剑
