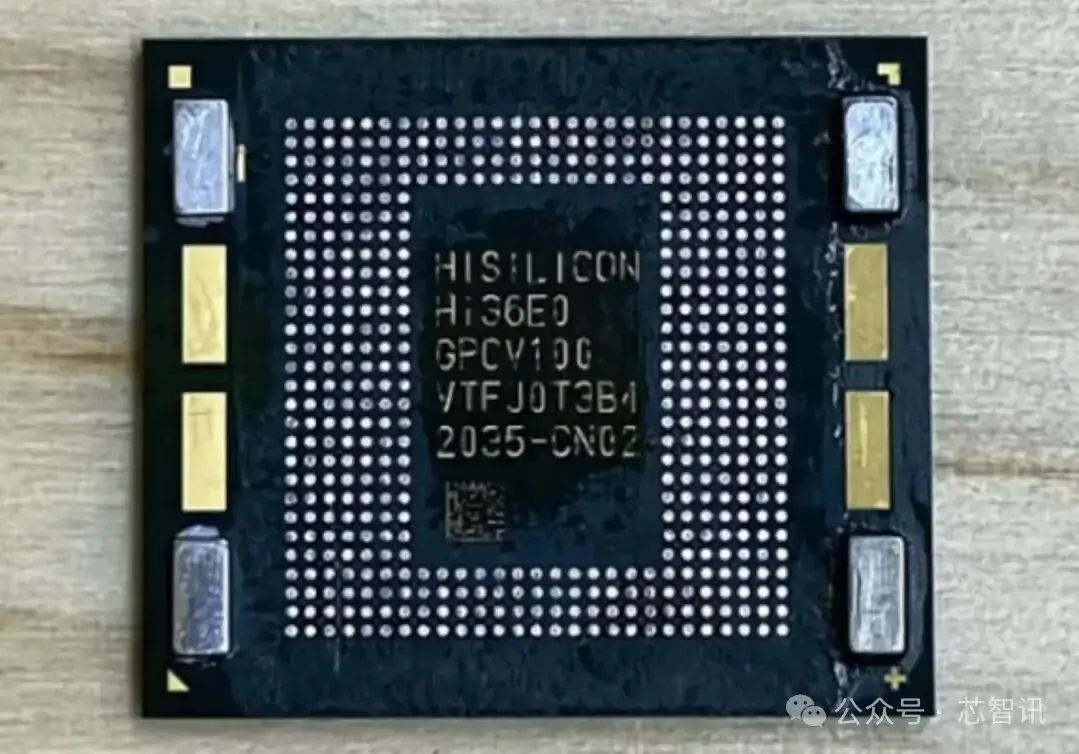
近日,半导体分析机构 Kurnal Insights 发布了华为麒麟9050 Pro(Hisilicon Hi36E0)芯片裸片照片(Die Shot),展示了这款基于华为“韬定律”逻辑折叠(LogicFolding)技术的全新SoC的内部结构。
逻辑Die+SARM Die折叠设计
Kurnal Insights公布的华为麒麟9050 Pro芯片的裸片照片显示,其并未采用传统的将计算单元与SRAM在同一个2D Die结构上的设计,而且分成了两个Die,即一颗计算Die(CPU/GPU/NPU/ISP/DSP等计算单元都在这个裸片上)与一颗SRAM Die(SRAM/Cache都在这个裸片上)通过“逻辑折叠”技术键合而成,这种方法缩短了信号链路,并利低至微米级间距的垂直互连,使两个Die在功能上作为一个单片单元运行。
据华为半导体业务负责人何庭波此前披露的论文阐述,所谓“逻辑折叠”,并非传统意义上的芯片堆叠:传统堆叠是将现成模块在封装层面连接,而逻辑折叠是将原本在平面上展开的完整逻辑系统,放到三维空间中重新设计、重新布线、重新定义时序,其不仅提升了芯片密度和性能,还优化了芯片的信号链路和电气链路,降低了功耗和时延。
从Kurnal公布的两个裸片的标注图来看,这两颗裸片尺寸均为11.13mm × 10.84mm,面积均为120.65mm²,虽然单个裸片的面积甚至略小于前代麒麟9030S的122mm²,但由于是两个裸片“逻辑折叠”而成,因此其整体的晶体管密度得到了大幅提升。
据爆料人@Taog_1575透露,麒麟9050 Pro的计算Die采用N+3工艺,SRAM Die则采用N+2工艺,这样的工艺组合,在麒麟芯片当中尚属首次。
根据华为半导体业务部总裁何庭波此前公布的论文数据显示,麒麟9050 Pro的晶体管密度达到每平方毫米2.38亿颗,较麒麟9030 Pro的每平方毫米约1.55亿颗晶体管提升了55%。不过,华为最新发布会披露的数据显示,如果只看计算Die的逻辑单元晶体管密度,则提升了约28%。
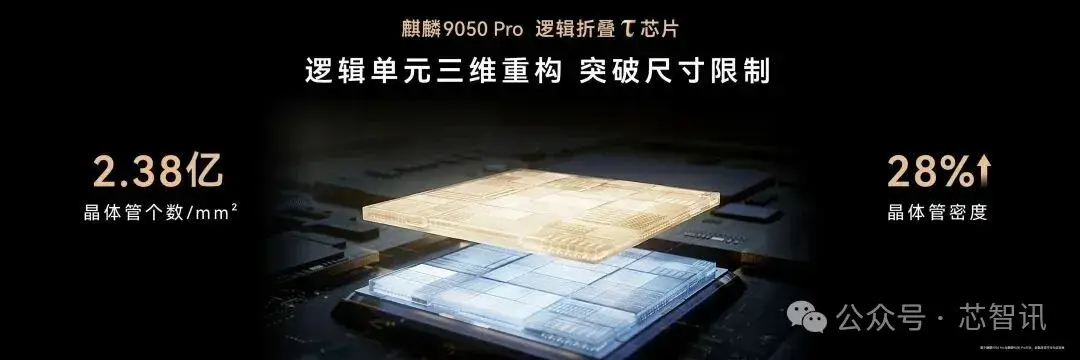
此外,麒麟9050 Pro通过创新的逻辑折叠架构,压缩关键路径时延,能将新芯片时钟缓冲器的数量降低55%,关键路径时延也减少30%。与此同时,麒麟9050 Pro还实现了500万个信号传输键合,跨Die传输带宽高达125TB/秒,这也助力了信号传输时延的降低。
根据华为官方的数据,麒麟9050 Pro相比上代麒麟9030 Pro的CPU多核性能提升了23%;该芯片还集成了一颗超低功耗微核,息屏显示、消息推送等低负载场景由微核运行,有效降低待机功耗;GPU图形渲染性能提升了40%;NPU性能提升了140%,可以在端侧运行30B MOE 大模型;集成的第十代ISP,可以将长焦清晰度提升34%;通信方面,集成了全新的巴龙基带,支持超5.5G通信。
计算Die:9核CPU+6核GPU+4核NPU
Kurnal公布的计算Die的标注图来看,麒麟9050 Pro的逻辑计算单元全部集中在这一层。
其中,左上方的区域是Maleoon 955 GPU,拥有6个GPU核心,主频为1056MHz,占据了相当大的裸片面积。
Maleoon 955 GPU的下方和右侧则是LinXi CPU区域。在具体CPU架构方面,麒麟9050 Pro搭载自研灵犀9核16线程CPU,采用1+6+2架构,包含一个主频3.1GHz的LinXi-Big大核和6个主频2.2GHz的LinXi-Mid中核和2个1.75GHz LinXi-Small小核。
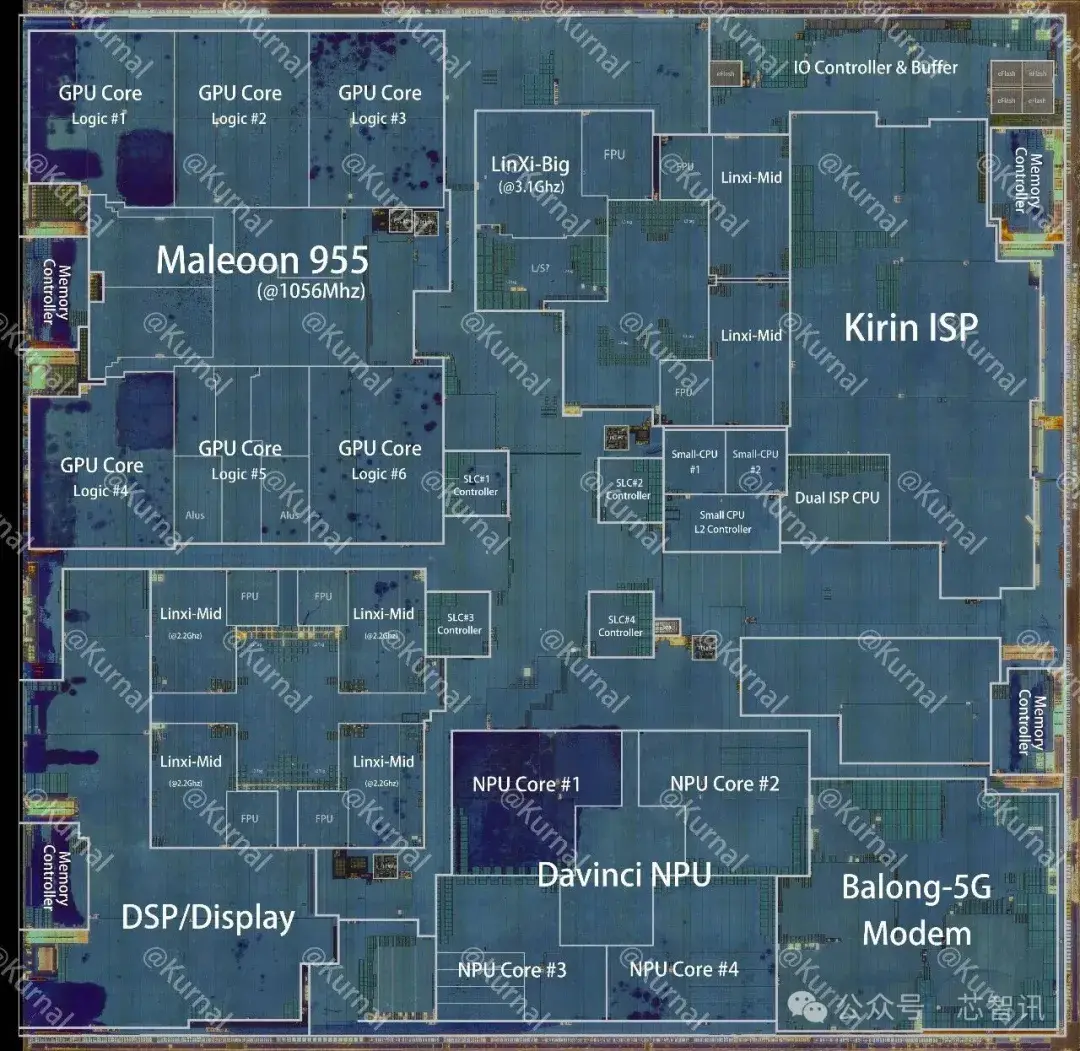
需要指出的是,从裸片照片来看,麒麟9050 Pro的CPU分拆成了不同位置的两个独立的集群:一个集群位于Maleoon 955 GPU右侧,拥有1个LinXi-Big大核+2个LinXi-Mid大核+2个LinXi-Small小核;另一个集群位于Maleoon 955 GPU下方,拥有4个LinXi-Mid中核。
计算Die右侧是面积相当大的Kirin ISP,并且该ISP还配备了专用的双核CPU核心;计算Die的下方中央是四核心的达芬奇(Da Vinci)NPU,左下方是DSP/Dispaly单元,右下方是巴龙(Balong)5G基带。
此外,计算Die内部还分布着多个Cach Controller,边缘还分布着多个Memory Controller和I/O Controller & Buffer等模块。
SRAM Die:与计算Die垂直耦合的有源多级缓存层
Kurnal公布的SRAM Die标注图显示,这一层并不是一片简单的“缓存仓库”,而是与计算Die高度对应的有源存储层。
其中,麒麟9050 Pro的六个Maleoon 955 GPU,不仅每个核心都配备了独立的一级缓存,同时还有4MB的共享二级缓存。
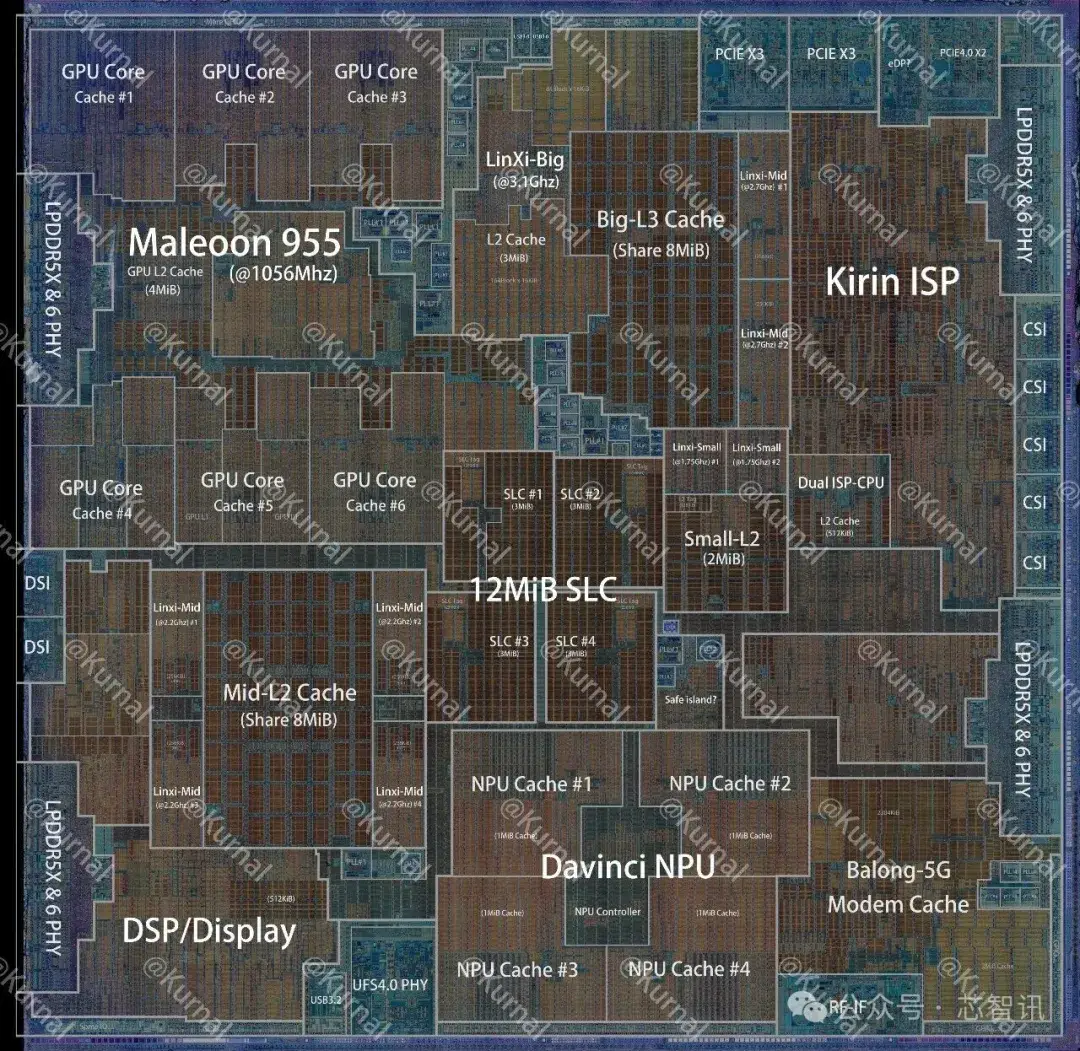
在CPU缓存方面,位于Maleoon 955 GPU右侧的5核CPU集群中,LinXi-Big大核配备了独立的3MB二级缓存,2个LinXi-Small中核分别配备了256KB的缓存,2个LinXi-Small小核则配备了2MB的共享二级缓存,这5个CPU核心还拥有共享的8MB三级缓存。
位于Maleoon 955 GPU下方的拥有4个LinXi-Mid中核的CPU集群,则配备了共享的8MB二级缓存。
在NPU方面,4个芬奇架构的NPU核心,每个核心均拥有独立的1MB缓存。
Kirin ISP专用的双核CPU,也配备了512KB的二级缓存;DSP/Display计算单元,配备了512KB缓存;巴龙5G基带也配备了2304KB缓存。
此外,麒麟9050 Pro还配备了12MB的SLC系统缓存,整个SoC的计算单元都能够进行调用。
其中,各个计算单元内部的Cache是解决局部、高频、低延迟数据访问;12MB SLC则承担更高一级的系统级数据共享;外部的LPDDR负责更大规模的数据存取。
需要指出的是,在SoC当中,计算单元和存储单元之间存在大量、高频、低延迟的数据交换,如果能够缩短互连距离,那么将能够大幅降低RC延迟、动态功耗和布线资源占用,因此将计算单元和存储单元进行垂直集成价值更高。
但是,麒麟9050 Pro的SRAM Die并不是一个简单的大容量共享Cache层,而是为CPU、GPU、NPU等计算单元配备了紧密耦合的独立多级Cache,并与SLC一起纳入了这个垂直缓存体系当中。逻辑Die上的各个计算单元和SRAM Die上的缓存之间,实际上构成了一组跨硅层的逻辑-存储垂直耦合关系,这比单纯的计算Die与DRAM进行3D堆叠更加复杂。
此外,SRAM Die上还有安全核心和NPU Controller,周围还分布着多个PCIe、LPDDR PHY、CSI、DSI、USB PHY、RF等相关单元。
小结:
虽然麒麟9050 Pro通过“逻辑折叠”设计将逻辑Die和SRAM Die垂直整合,确实在带宽、时延、功耗和晶体管密度等方面带来了显著收益,但是这并非没有代价。
一方面,两颗Die若要稳定协同工作,必须依赖高精度晶圆减薄、混合键合(Hybrid Bonding)以及极高精度的对准与互连工艺。另一方面,传统单Die设计中,若Die出现损坏,通常只影响一颗Die;而在Logic Die + SRAM Die + Bonding的架构下,任一环节出现问题,都可能拖累最终封装良率,甚至导致两颗Die同时报废。
因此,麒麟9050 Pro的“逻辑折叠”方案在换取性能与能效提升的同时,也对制造工艺、键合精度和良率控制提出了更高要求。
编辑:芯智讯-浪客剑